脆弱性チェックを週1で自動化した。いちばん難しかったのは「黙らせる」ことだった
PHPの脆弱性騒ぎのとき、自分が影響するかを確かめるのに51,009ファイルを走査しました。答えは出ましたが、騒ぎのたびにこれをやるのは続きません。そこで、週に1回まとめて見る仕組みをクラウド上に作りました。作ってみて分かったのは、脆弱性を見つける部分はほとんど難しくないということです。難しいのは逆で、何も無い週にきちんと黙らせることでした。毎週76件を並べられても読まなくなり、読まなくなった通知は無いのと同じになります。この記事では、2回やり直した設計と、その過程で踏んだ3つの失敗を、実測値をつけて書きます。情報は2026年10月24日時点のものです。
作ったもの — 何も無い週は3行で終わり、通知も鳴らない
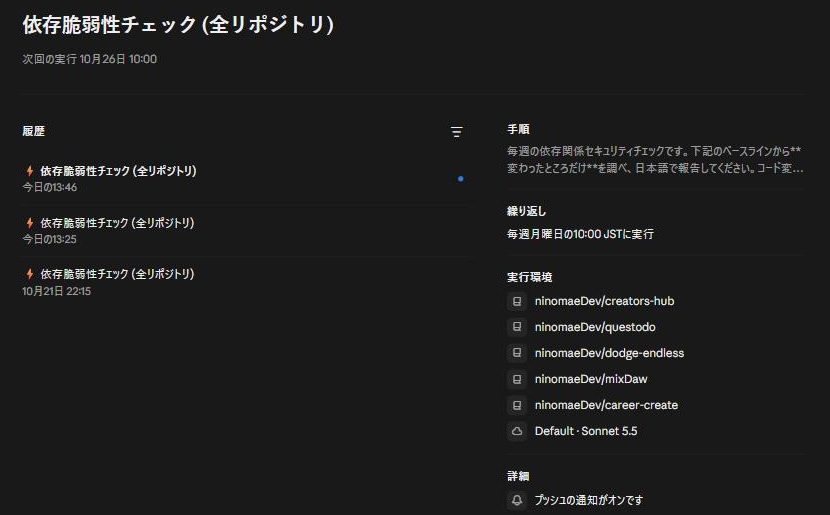
毎週月曜の朝10時に、クラウド上で自分のリポジトリ5つ分の依存関係を監査する仕組みを置きました。対象はマニフェストで6か所、npmが5か所とPythonが1か所です。自分のPCは関係なく動くので、電源が入っていなくても結果だけが残ります。
判定は4段階にしました。緊急、要対応、様子見、異常なし。そして異常なしのときは、全体を3行以内で終わらせて、スマホへの通知も送らないようにしています。この「送らない」が今回いちばん時間をかけた部分です。
何かあったときだけ、5行以内の通知がスマホに飛びます。中身は判定と、対応が必要なパッケージと、叩けばいい具体的なコマンドだけです。根拠や経緯は通知に入れず、記録のほうに残します。通知を読む時点で欲しいのは「何をすればいいか」であって、理由は後から読めば足りるからです。
実際に動かしてみて、High 4件とHigh 1件(本番依存)が見つかり、どちらも解消しました。後の章に書きます。先に、なぜこれを作ったのかと、どこで2回転んだのかを書きます。
きっかけ — 持ち物の一覧が無いと、毎回ゼロから調べることになる
2026年10月21日にPHPの重大な脆弱性が公開されたとき、自分が影響するかを確かめました。手元43フォルダ51,009ファイルとGitHubの8リポジトリ1,344ファイルを走査して、PHPは0件。公開しているサイトもPHPを実行できない場所で動いていることを確かめて、影響なしと結論しました。その記録は別の記事に書いています。
やること自体は単純でした。ただ、時間がかかったのは脆弱性の中身を理解する部分ではなく、「自分が何を使っているのか」を洗い出す部分でした。そして洗い出しの結果はどこにも残らないので、次に別の騒ぎが起きたらまた同じことをやることになります。
企業だと、ここは資産台帳と脆弱性スキャナが埋めています。情報が流れてきたら、台帳と自動で突き合わせて「該当120台」と出る。人間が判断するのはその後からです。個人開発でそこまでは要りませんが、「毎回ゼロから数える」のだけはやめたいと思いました。
それで、騒ぎが起きてから調べるのではなく、週1で勝手に見ておく形にしました。やっていることは企業の仕組みの縮小版で、入口が`npm audit`、判定が到達可能性と公開面、配信がスマホ通知、という三段構えです。
何を見ているか — npm audit を2回走らせて差を取る
中身はほとんどこれだけです。各プロジェクトで`npm audit`を2回走らせます。1回目は全体、2回目は本番依存だけに絞ったものです。
大事なのは件数そのものではなく、2つの差です。全体には出るのに本番依存には出ないものは、ビルド時や開発時にしか通りません。テストランナーやビルドツールの脆弱性は、自分のPCでテストを走らせるときにしか経路がないので、公開しているサーバーに穴が開いているのとは話がまったく違います。CVSSのスコアだけ見ていると、この区別が消えます。
実際に測るとこうなりました。2026年10月24日時点の数字です。インターネットに公開しているのはcreators-hub(このサイト)だけで、そこの本番依存は0件でした。全体では11件ありますが、すべてビルド・開発用です。
逆に注意が要るのがdodge-endlessのElectronでした。これはdevDependencyに入っていますが、Electron本体はビルド時にゲームの配布物へそのまま同梱されます。つまり「開発依存だから後回し」という判断が通用しません。npmの分類と、実際に配られるものの中身は一致しないことがあります。
各プロジェクトで2回走らせる
# 全体
npm audit --json > all.json

# 本番依存のみ
npm audit --omit=dev --json > prod.json

# この2つの差が判定の核。
# prod.json に出ないものはビルド時・開発時にしか通らない
失敗その1 — 通知が一生飛ばない設計にしていた
毎週76件を並べられても読まないので、「既知のものは報告しない」というベースラインを作りました。一度確認したものは一覧に載せておいて、そこに無いパッケージが出たときだけ新規として扱う、という仕組みです。これ自体は正しい発想でした。
問題は、その一覧にelectronを入れてしまったことです。electronは「修正版が出ていて、まだ当てていない」もの、つまり本来やることが残っている項目でした。それを既知扱いにしたせいで、判定は毎週「異常なし」になります。異常なしのときは通知を送らない設計なので、結果として通知は永久に飛びません。欲しかった機能が、設定した瞬間に死んでいました。
原因は、「既知」と「対応済み」を同じ箱に入れたことです。どちらも「もう知っている」点では同じですが、前者はまだ宿題が残っていて、後者は終わっています。これを混ぜると、終わっていないものが静かに消えます。
直したあとは3段に分けました。A は対応済みで、版が下がっていないかだけ見ます。B は修正版がまだ出ていないもので、状況が変わったかだけ見ます。C がベースラインで、変化が無ければ黙ります。やることが残っているものはAにもCにも入らないので、沈黙に紛れません。
この分け方で、判定の意味もはっきりしました。異常なしは「見ていない」ではなく「Aに退行なし、BもCも変化なし」です。何を確かめた上で黙っているのかが決まっていないと、静かなことが安心にならないからです。
3段に分けた
A. 対応済み   → 版が下がっていないかだけ確認。保たれていれば何も書かない
B. 修正版待ち → 修正版が出たかだけ確認。出ていなければ何も書かない
C. ベースライン → 既知の一覧。ここに無い名前が出たときだけ「新規」

判定:
  異常なし = Aに退行なし / Bに変化なし / Cから新規なし
  それ以外 = 変わったものだけを書き、スマホに通知する
失敗その2 — 届かない通知を作りかけた
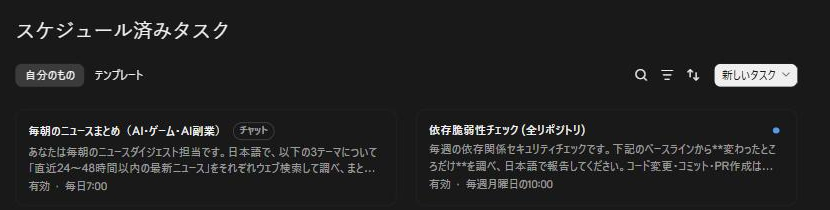
次に気づいたのは、作ったルーティンがスマホのアプリから見えないことでした。最初は「この手の機能はスマホアプリに無いのだろう」と考えましたが、これは外れでした。同じアカウントに別のルーティン(毎朝のニュースまとめ)があり、そちらはスマホに出ていたからです。
2つの設定を並べて比べたところ、決定的に違うのは参照するリポジトリの有無でした。ニュースのほうは検索して文章を書くだけなのでリポジトリを必要としません。一方こちらは、privateリポジトリ5つをクローンして`npm audit`を走らせます。リポジトリのチェックアウトが要る処理なので、置かれている場所が違う、という形でした。
ではリポジトリを外せばスマホに出るのかというと、それだとロックファイルが読めず、監査そのものが成立しません。privateなので外から取ることもできません。つまり「一覧をアプリに出すこと」と「実際に監査すること」は両立しませんでした。
そこで方針を変えて、一覧ではなく結果のほうをスマホに届けることにしました。プッシュ通知です。試しに走らせたところ、要対応の判定とともに通知が実際に送信されました。一覧が見えなくても、必要な情報は受け取れます。見たくなったときは、アプリではなくブラウザで管理画面を開けば一覧も読めます。
教訓としては単純で、通知の仕組みを作るときは、鳴らす条件より先に「本当に届くか」を確かめたほうがいいということです。条件を丁寧に設計しても、経路が無ければ全部無駄になります。
環境の制約は推測せず、1回測って書き込む
最初に書いたプロンプトには、CISAが公開している「実際に悪用が確認された脆弱性」のリスト(KEV)を見る手順を入れていました。深刻度を紙の上のスコアではなく実態で測れるので、判断材料として有効なはずだったからです。
ところが、クラウドの実行環境からはこのリストが取得できませんでした。curlではプロキシが403を返し、別の取得手段でも名前解決そのものが通りませんでした。2回の実行で両方の経路が塞がっていることが確定したので、手順から消しました。GitHubのアドバイザリAPIも、クローン済みのリポジトリ以外は拒否されることが分かったので同じく消しました。
消す前は、毎回エージェントが届かない先に何度もアクセスを試みて、そのたびにやり取りが増えていました。できないことを「できない」と明記しておくだけで、動きがはっきり変わります。実行のやり取りは9回から3回に、所要時間は100秒から50秒になりました。半分です。
代わりに、使えるものも書き込みました。脆弱性の詳細、つまり影響範囲も修正版も依存経路も、実は`npm audit --json`の出力にすべて入っています。外部のAPIを引く必要は最初からありませんでした。また、入っていないと思っていたPythonの監査ツールは、その場でインストールすれば使えることが分かりました。
どれも、やってみるまで分からなかったことです。そして一度測れば、次からは測り直す必要がありません。こういう「環境の癖」を設定の中に残しておくのは、手順そのものを書くのと同じくらい効きます。
実際に見つかって直したもの
仕組みを整えた結果、dodge-endless(Steamで出している弾幕回避ゲーム)に2件見つかりました。
1件目はElectronです。43.1.0を使っていて、影響範囲が43.0.0-alpha.1から43.8.0までのHighが4件ありました。修正は43.5.0以上で、43系の最新である43.8.3に上げるだけで解消します。メジャー更新は不要でした。前述のとおりElectron本体は配布物に同梱されるので、devDependencyでも本番相当として扱っています。
2件目は@xmldom/xmldomです。こちらは本当の本番依存で、描画ライブラリのpixi.js経由で入っていました。0.8.13で、影響範囲は0.8.14以下です。修正版の0.8.15が同じ0.8系の中に出ていたので、要求元の条件を壊さずに上げられました。pixi.jsとelectron-builder配下のplistがそれぞれ範囲を指定していましたが、どちらも0.8.15を含んでいたので、オーバーライドの指定も要りませんでした。
両方を上げた結果、このプロジェクトの本番依存の脆弱性は0件になりました。型チェックとビルドを通し、テストは17ファイル209件すべて成功、Electron本体もバージョンを返すところまで確かめています。
どちらも、やってみれば1コマンドで終わる話でした。見つけるのが難しいのではなく、見つけ続ける仕組みが無かっただけです。
実際に叩いたコマンドと結果
# 1. Electron(配布物に同梱される。メジャー更新は不要)
npm install -D electron@43.8.3

# 2. @xmldom/xmldom(pixi.js経由の本番依存。0.8系の範囲内で上がる)
npm update @xmldom/xmldom

# 確認
npm audit --omit=dev    # → 0件
npx electron --version  # → v43.8.3
npm run build           # → 成功
npm test                # → 17ファイル 209テスト 全通過
数字をそのまま信じない — Expoの「本番依存27件」の読み方
もう一つ、測ってみて分かった落とし穴があります。iOSアプリのほう(Expo / React Native)を監査すると、全28件のうち27件が「本番依存」と出ます。数字だけ見ると、公開しているサイトより桁違いに危ないように見えます。
中身を見ると、そうではありませんでした。並んでいるのは`@expo/cli`、`@expo/metro-config`、`xcode`、`@expo/config-plugins`といった、ビルドやCLIのためのパッケージです。これらは`expo`本体がdependenciesにあるので、その配下として機械的に本番依存へ数えられているだけで、端末に配られるアプリのバンドルには入りません。
つまりnpmの「本番依存」という分類は、エコシステムによって意味がずれます。ウェブのサーバーなら本番依存はそのままサーバー上で動くものですが、モバイルアプリではビルド用のツールチェーンまで含まれてしまいます。ここを読み違えると、優先度を完全に取り違えます。
なので設定の中に、この例外を文章で書いておきました。「questodoの本番依存27件という数字をそのまま深刻に扱わないこと」と明記しています。自動化した仕組みに任せるときは、こういう例外こそ言語化しておかないと、毎週まちがった優先度で報告されることになります。
直さないと決めたものも、記録しておく
全部直したわけではありません。むしろ、直さないと決めたものを明示的に記録したことのほうが、運用としては効いている気がします。
DAWプロジェクトの動画書き出し部分に、本番依存扱いで11件残っています。修正にはライブラリ群のメジャー更新が必要で、これはローカルで動画を書き出すためだけのものなので、外から触られる経路がありません。テストランナーのCriticalも2件ありますが、こちらも自分のPCでテストを走らせるときにしか通らず、修正にはメジャー更新が要ります。
これらを「未対応」のまま毎週報告させると、通知が鳴り続けて、そのうち全部読まなくなります。かといって黙って消すと、判断した事実まで消えます。なので「公開面が無いので承知のうえで保留」と理由つきでベースラインに入れました。次に見たときの自分が、もう一度同じことを調べずに済みます。
セキュリティの判断は、直すか直さないかの二択ではありません。直さないと決めることも判断で、それには根拠と期限が要ります。記録が残っていれば、状況が変わったとき(公開することになった、メジャー更新をするついでができた)に、すぐ引き直せます。
いまの状態はこうです。異常がなければ月曜の朝に3行だけ残って、スマホは鳴りません。何かあれば5行の通知が来ます。検知の精度より、この静けさのほうを時間をかけて作りました。鳴らない仕組みは信用できませんが、鳴りっぱなしの仕組みはもっと信用できないからです。
よくある質問
Q. 個人開発でここまでやる必要がありますか?
全部は要りません。ただ「自分が何を使っているかの一覧」だけは、作っておくと効きます。脆弱性の騒ぎが起きたとき、一覧があれば数分で影響の有無が出ますが、無いと何時間かけても「たぶん大丈夫」としか言えません。週1の自動化まで組まなくても、リポジトリごとに`npm audit --omit=dev`を一度走らせて結果を書き留めておくだけで、次が楽になります。
Q. Dependabot などの既存の仕組みではダメなんですか?
ダメではなく、併用できます。違いは判定の部分です。Dependabotはバージョンが上がったら教えてくれますが、「それが自分の環境で到達可能か」「公開面に影響するか」までは判断しません。今回の仕組みでやりたかったのは検知そのものより、到達可能性と公開面で優先度を決めて、必要なときだけ鳴らすという部分でした。検知だけなら既存のもので足ります。
Q. 「本番依存」と「開発依存」はどう見分ければいいですか?
`npm audit`を2回走らせて差を取るのが基本です。`npm audit --json`(全体)と`npm audit --omit=dev --json`(本番依存のみ)を比べて、後者に出ないものはビルド時・開発時にしか通りません。ただし例外があります。ElectronアプリのElectron本体はdevDependencyでも配布物に同梱されますし、逆にExpoは`@expo/cli`のようなビルド用CLIまで本番依存に数えます。分類を鵜呑みにせず、実際に配られるものに入るかで考えてください。
Q. 通知が多すぎて読まなくなるのを防ぐにはどうすればいいですか?
何も無い週は通知を送らない、と決めるのが一番効きます。そのうえで、通知が来る条件を自分で説明できる状態にしておくことです。今回は「対応済みのものが退行した」「修正版が無い既知のものに変化があった」「一覧に無いパッケージが出た」の3つに絞りました。通知が来た=自分が何かしないといけない、という状態を保てれば、件数は自然に減ります。
Q. 修正版が出ていない脆弱性はどうすればいいですか?
到達経路があるかどうかで分けてください。本番で動くコードから届くなら、回避設定やWAFで時間を稼ぎつつ上流の対応を待ちます。ビルド時にしか通らない、ローカルでしか動かない、という場合は、修正版が出るまで記録して保留で構いません。大事なのは「保留」と決めた理由を残すことです。残っていないと、次に見たときにまた同じ調査をやり直すことになります。